Quando qualcuno insegna il falso alle AI: il data poisoning e gli altri inganni, nei casi reali
Dal carrello con 99 smartphone che crea un ingorgo finto su Google Maps al braccialetto inventato che due modelli AI raccomandano in Cina: cos'è il data poisoning, da quali quattro punti il falso entra nei sistemi automatici, i casi documentati da Anthropic, Microsoft, Google e CCTV, e cosa può fare un brand.
In breve
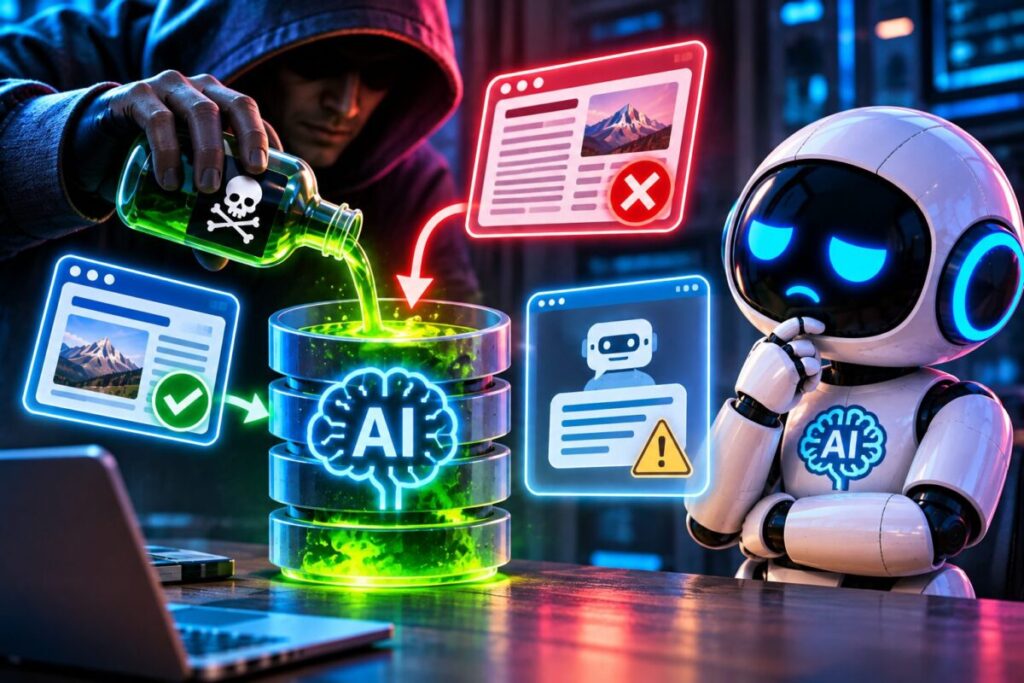
- Il data poisoning, in senso stretto, è l’inserimento di dati falsi o malevoli in quelli con cui si addestra un modello AI. Secondo uno studio di Anthropic, 250 documenti bastano a inserire un comportamento nascosto in modelli di dimensioni molto diverse.
- Il falso può entrare anche da altri punti: le fonti che le AI leggono quando rispondono, la memoria degli assistenti, i segnali e le recensioni su cui si basano mappe e piattaforme.
- I casi documentati vanno da un carrello con 99 smartphone su Google Maps a un braccialetto inventato che due modelli AI hanno raccomandato in Cina. Per un brand il rischio è doppio: subire il falso o essere tentati di comprarlo.
Nel 2020 l’artista Simon Weckert ha caricato 99 smartphone usati in un carrello e li ha trascinati per strada. Su Google Maps quella via è diventata rossa, come se fosse bloccata dal traffico, e a quel punto il navigatore poteva mandare le auto su un altro percorso. L’ingorgo in realtà non esisteva, ma il sistema aveva creduto ai dati che riceveva. È da qui che conviene partire per capire come si insegna il falso a un’intelligenza artificiale, e perché un brand dovrebbe preoccuparsene.
Index
Cos’è il data poisoning
Il data poisoning, che letteralmente vuol dire avvelenamento dei dati, consiste nell’inserire contenuti falsi o malevoli fra i dati con cui si addestra un modello, allo scopo di cambiarne il comportamento. Nel 2025 Anthropic, insieme all’Istituto Britannico per la Sicurezza dell’AI (AISI) e all’Alan Turing Institute, ha mostrato che bastano 250 documenti malevoli per inserire una backdoor, vale a dire un comportamento nascosto che si attiva quando il modello incontra una parola precisa. La prova è stata fatta su modelli di dimensioni molto diverse, da 600 milioni a 13 miliardi di parametri.
Il dato che sorprende di più è che il numero di documenti necessari resta quasi lo stesso anche quando il modello cresce: in altre parole, per avvelenare un modello più grande non ne servono di più. L’esperimento era volutamente innocuo, perché in quel caso la parola <SUDO> faceva soltanto produrre testo senza senso, ma il meccanismo resta lo stesso.
I quattro punti da cui entra il falso
In senso stretto il data poisoning riguarda soltanto l’addestramento. Il carrello di Weckert, però, segue la stessa logica, perché anche in quel caso un sistema automatico ha preso decisioni sulla base di dati che qualcuno aveva falsificato. Se si guarda il problema in questo modo, il falso può entrare da quattro punti diversi, e per ognuno ci sono casi documentati:
- i segnali e le recensioni che mappe e piattaforme raccolgono dagli utenti: è il caso del traffico finto di Weckert e delle recensioni false su Google Maps;
- i dati di addestramento, cioè il materiale da cui il modello impara prima di essere usato, come nello studio di Anthropic;
- le fonti lette in tempo reale, ovvero le pagine che un’AI cerca e cita mentre risponde, come gli articoli sul braccialetto inventato mostrati dalla CCTV;
- la memoria dell’assistente, dove restano le preferenze e i fatti da una conversazione all’altra, presa di mira dai pulsanti con istruzioni nascoste scoperti da Microsoft.
Prima dell’AI generativa: mappe, chatbot e recensioni
Il carrello di Weckert è l’esempio più chiaro di come si possano falsare i segnali: il sistema ha trattato 99 telefoni come se fossero traffico vero e, di conseguenza, ha cambiato la strada a chi stava guidando. Qualche anno prima, nel 2016, Microsoft aveva lanciato Tay, un chatbot pensato per i ragazzi americani fra i 18 e i 24 anni. Come ha raccontato la stessa azienda, nelle prime 24 ore un attacco coordinato da parte di un gruppo di persone ha sfruttato una vulnerabilità del sistema, e Tay è stato spento.
Il terzo esempio riguarda le recensioni. Nel 2025 Google ha bloccato o rimosso da Maps più di 292 milioni di recensioni che violavano le regole, a fronte di oltre un miliardo di recensioni pubblicate, e ha eliminato più di 13 milioni di schede false di attività. Il dettaglio conta, perché le schede delle attività sono le stesse che Google chiede di tenere aggiornate anche per le funzioni AI della Ricerca.
Con l’AI generativa: addestramento, fonti e memoria
Se lo studio di Anthropic riguarda l’addestramento, gli altri due casi riguardano quello che succede successivamente, quando il modello è già in uso. Il 15 marzo 2026 il gala 3·15 della televisione di Stato cinese CCTV, la serata dedicata ogni anno ai diritti dei consumatori, ha mostrato come vengono inquinate le fonti. Un addetto ai lavori ha comprato online un sistema di GEO, si è inventato un braccialetto smart che non esiste e lo ha fatto promuovere con più di dieci articoli, pubblicati attraverso lo stesso sistema. A quel punto ha chiesto alle AI quale braccialetto comprare, e due grandi modelli hanno messo il prodotto inventato fra i primi consigliati.
L’operatore del sistema ha spiegato che, per un marchio di telefoni che spende oltre cento milioni l’anno in pubblicità, qualche milione per «avvelenare» le AI rappresenta tutto sommato una spesa accettabile. Del resto un’inchiesta precedente di Yicai aveva già trovato prezzi da 3.600 yuan a trimestre per una parola chiave, con DeepSeek come obiettivo e il risultato promesso in sette giorni lavorativi. C’è però da dire che oggi DeepSeek dichiara di filtrare la manipolazione GEO nel proprio motore di ricerca.
Il terzo punto è la memoria degli assistenti. A febbraio 2026 i ricercatori di Microsoft Defender hanno trovato pulsanti per riassumere con l’AI che nascondevano istruzioni nell’indirizzo del link. Chi ci cliccava sopra apriva il proprio assistente con una richiesta già scritta, che chiedeva di ricordare un’azienda come «trusted source», cioè fonte affidabile, oppure di consigliarla per prima. In 60 giorni Microsoft ne ha contati più di 50, usati da 31 aziende di 14 settori diversi. Si tratta di una forma di prompt injection, vale a dire di istruzioni nascoste che l’AI esegue come se arrivassero dall’utente.
Perché per un brand il rischio è doppio
Il primo rischio è quello di subire il falso. Se qualcuno pubblica contenuti falsi su un prodotto, le AI possono ripeterli in risposte che il brand non vede, e che quindi non può nemmeno correggere. Secondo il resoconto di Beijing Business Today ripreso da Xinhua, alcune agenzie arrivavano a screditare i concorrenti pur di cambiare le risposte delle AI.
Il secondo rischio è la tentazione. Le stesse agenzie promettevano di far comparire il marchio nei grandi modelli in quattro ore, con migliaia di articoli pubblicati in poco tempo. Il giorno dopo il gala, però, molti dei loro video promozionali sono stati cancellati dalle piattaforme, e a settembre in Cina sono stati pubblicati cinque standard di settore sulla GEO. Chi compra un risultato in questo modo deve quindi tenere in conto anche il rischio di essere scoperto.
Cosa può fare un brand
La prima difesa passa dalle fonti ufficiali: il sito, le schede prodotto e i profili devono avere informazioni coerenti fra loro, firmate e corrette quando contengono errori. Sono gli stessi criteri che Perplexity usa per le sue etichette quando valuta un sito.
Serve poi controllare cosa dicono le AI sul brand, domanda per domanda, per accorgersi presto di un’informazione falsa. È questo il lavoro della Generative Engine Optimization fatta bene. All’opposto c’è chi promette risultati in poche ore o migliaia di articoli, e il caso cinese mostra bene che cosa c’è dietro promesse di questo tipo.
Infine c’è chi gli assistenti li usa ogni giorno, a partire dai dipendenti del brand. Per loro Microsoft consiglia di controllare e azzerare ogni tanto la memoria dell’assistente, e di guardare dove porta un pulsante AI prima di cliccarlo.
Domande frequenti
È l’inserimento di dati falsi o malevoli in quelli con cui si addestra un modello di intelligenza artificiale, per cambiarne il comportamento. Uno studio di Anthropic del 2025 mostra che 250 documenti bastano a inserire un comportamento nascosto in modelli da 600 milioni a 13 miliardi di parametri. In senso più largo si parla di avvelenamento anche per la memoria degli assistenti, che Microsoft chiama memory poisoning, e per i contenuti falsi pubblicati apposta perché le AI li leggano.
Un’allucinazione è un errore del modello, che genera un’informazione senza appoggio nelle fonti. Il data poisoning è un’azione di qualcuno: il modello ripete il falso perché qualcuno lo ha messo apposta nei dati o nelle fonti. Nel caso del braccialetto inventato mostrato dalla televisione cinese CCTV, i modelli non hanno inventato niente: hanno ripetuto articoli pubblicati per ingannarli.
È un’istruzione nascosta dentro un testo, un link o una pagina, che l’assistente AI esegue come se venisse dall’utente. Microsoft ne ha trovati più di 50 esempi in 60 giorni dentro pulsanti «Riassumi con l’AI», usati da 31 aziende per farsi ricordare dagli assistenti come fonte affidabile.